 敦煌金石·刊本
DeepSeek AI · 纯强化学习数学与代码推演新纪元
DeepSeek - 探索未至之境
立足深度推理架构,以无监督纯强化学习激发生命力。在 DeepSeek官网 与 DeepSeek网页版 中,长思维链自反思推演已全面开放,打破传统预训练算力桎梏。
Architecture & Capability
纯强化学习驱动的极致推演架构
01. 纯强化学习
Cold-Start 自涌现
跳过大规模人工标注监督微调,模型通过原生强化学习探索自主演化,在复杂逻辑难题中产生高维推演跃迁。
02. 长思维链
思考过程可视化
动态展示长达数万字符的推导链路、策略回溯与自我批判过程,让每一次决策完全具备透明度与鲁棒性。
03. 稠密与MoE
DualPipe 流水线
自研高并发通信并行架构,将计算与跨节点传输延迟极限压低,实现千万量级 Token 高并发稳定吞吐。
04. 评测框架
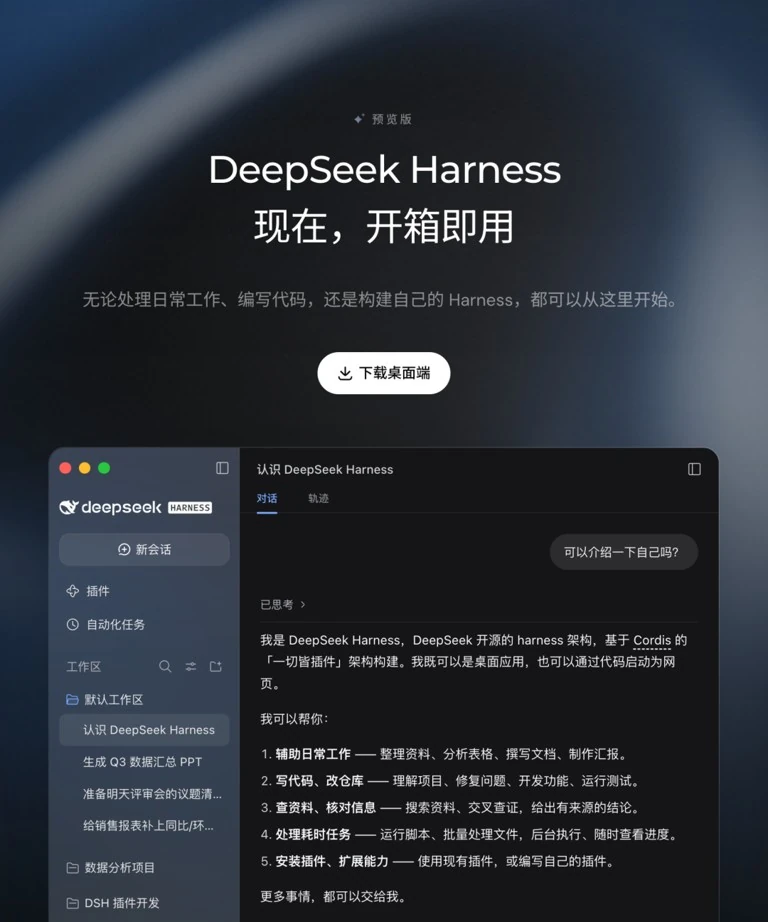
DeepSeek Harness
官方配套提供完整的基准测评工作流,覆盖 AIME、MATH、Codeforces 等全球顶尖学术考核标准。
金石印记 · 模型架构
基于自研 MoE 专家混合架构,实现高参数容量与轻量级推理并行的工程突破。
飞天流线 · 蒸馏全家桶
将 R1 深度思考能力全量蒸馏至 1.5B ~ 70B 稠密小模型,全面赋能端侧与边缘设备。
矿物晶体 · 极致吞吐
通过硬件协同优化算力调度,为企业级开发者提供行业性价比顶尖的 API 服务。
权威基准评测验证 (Benchmark Verification)
与全球顶尖闭源与开源大模型在数学、代码及通用推理能力上的硬核横评数据
| 测评基准领域 (Benchmark) | DeepSeek-R1 (官方) | OpenAI o1-preview | Claude 3.5 Sonnet | GPT-4o (通用版) |
|---|---|---|---|---|
| AIME 2024 (全球高难度数学竞赛) | 79.8% | 79.2% | 39.4% | 25.7% |
| MATH-500 (数学全域高难度题集) | 97.3% | 96.4% | 78.3% | 74.6% |
| Codeforces (算法竞赛排位评级) | 2029 (Percentile 96.3%) | 1891 | 1659 | 1340 |
| MMLU (多学科专业综合知识) | 90.8% | 91.8% | 88.7% | 87.2% |
| SWE-bench Verified (真实工程代码修复) | 49.2% | 41.6% | 48.9% | 38.8% |