 开放平台·接入指南
from openai import OpenAI

# 初始化 DeepSeek 开放平台客户端
client = OpenAI(
    api_key="sk-deepseek-your-api-key",
    base_url="https://api.deepseek.com"  # 兼容端点
)

# 发起 DeepSeek-R1 深度推理请求
response = client.chat.completions.create(
    model="deepseek-reasoner",  # R1 深度思考模型
    messages=[
        {"role": "system", "content": "你是一个精通数论与底层算法的专家。"},
        {"role": "user", "content": "求解丢番图方程 x^3 + y^3 = z^3 在正整数域内的解。"}
    ],
    stream=True
)

for chunk in response:
    # 实时解析长思维链思考内容与最终推理
    if hasattr(chunk.choices[0].delta, 'reasoning_content') and chunk.choices[0].delta.reasoning_content:
        print(chunk.choices[0].delta.reasoning_content, end="", flush=True)
    elif chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
高性价比透明计费方案
DeepSeek-R1
¥1.00 / 百万Token(入)
- 缓存命中低至 ¥0.14/M
- 输出价格 ¥4.00/M
- 支持完整思维链流式输出
- 最大支持 64K 上下文
DeepSeek-V3
¥0.50 / 百万Token(入)
- 缓存命中低至 ¥0.07/M
- 输出价格 ¥2.00/M
- 通用代码与多语言极速生成
- 日常业务生产力首选
R1-Distill-70B
¥0.40 / 百万Token(入)
- Llama-3.3 蒸馏架构
- 输出价格 ¥1.60/M
- 极低延迟端侧部署支持
- 开源权重可离线微调
R1-Distill-8B
¥0.10 / 百万Token(入)
- 单卡 GPU 即可加载运行
- 输出价格 ¥0.40/M
- 边缘设备实时推理利器
- 权重完全开源 Apache 2.0
集群弹性扩展调度
采用全球多地域机房冷热分离部署,确保高并发调用下的 99.95% 可用性 SLA。
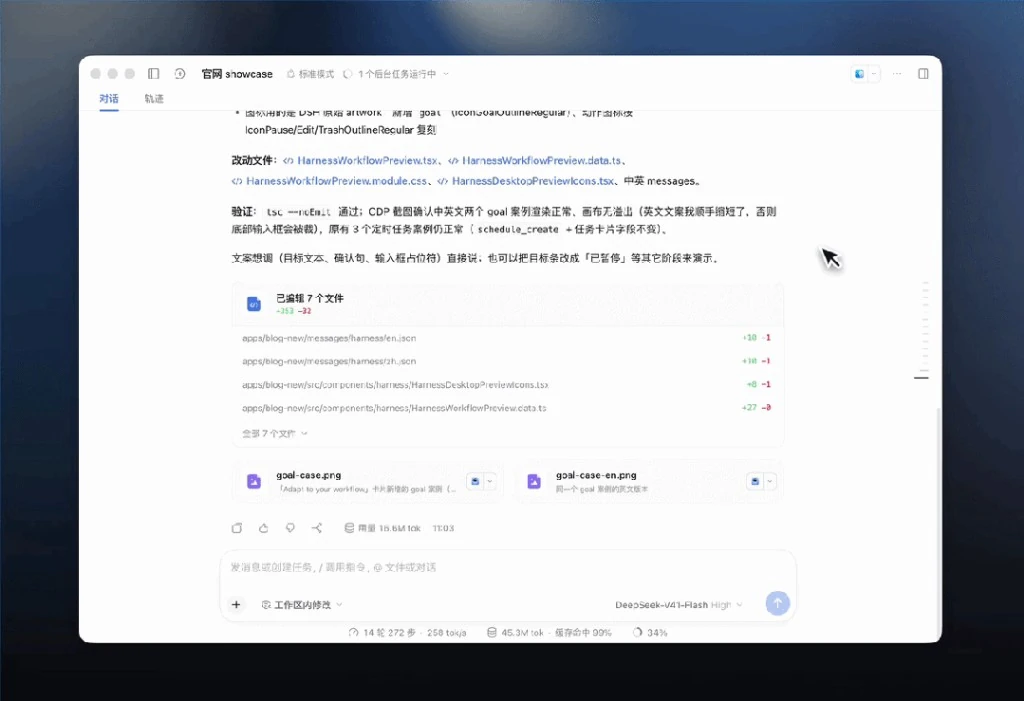
DeepSeek Harness 框架
内置标准评估工作流,支持一键复现 AIME 2024、MATH-500 与 SWE-bench 数据。
本地与私有化交付
提供基于 vLLM、SGLang、Ollama 等流行推理框架的量化与高效权重加载方案。
开发者常见问题与技术支持 (FAQ)
Q: 如何在现有 LangChain / LlamaIndex 项目中无缝替换为 DeepSeek?
只需在实例化 ChatOpenAI 或对应客户端时,指定
openai_api_base="https://api.deepseek.com" 并提供您的 DeepSeek API Key 即可。整个过程无需更改任何 Prompt 工程与链路逻辑。
Q: DeepSeek-R1 的“思维链(Reasoning Content)”是否占用计费 Token?
是的,模型在推理过程中生成的思维链内容属于输出 Token,按对应的每百万输出 Token 单价进行计费。通过流式 API 可以选择是否在前端界面展示该字段。
Q: 开放平台是否有并发调用速率限制(Rate Limits)?
默认开发者账户支持最高 500 RPM 与 100,000 TPM。如果您的企业有更高的业务吞吐与私有 Dedicated 独享节点需求,可联系技术支持进行企业通道快速扩容。
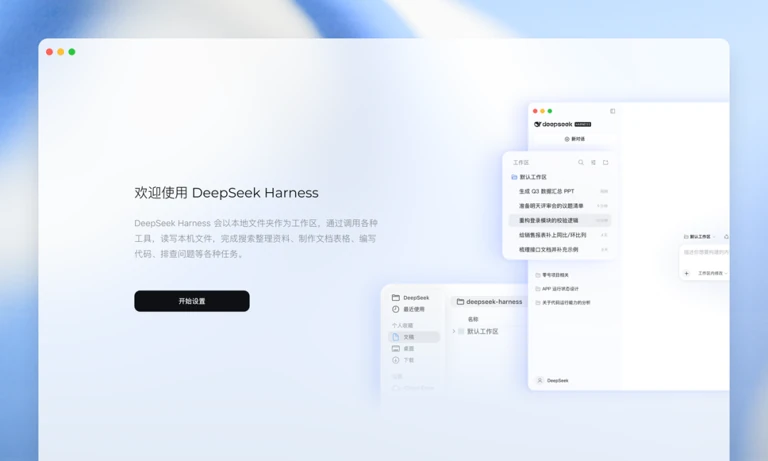
Q: 如何使用 DeepSeek Harness 进行本地模型评测?
可通过 Git 克隆官方 Harness 评测仓库,执行
python -m deepseek_harness --model deepseek-ai/DeepSeek-R1 --tasks aime2024,math_500 即可全自动化生成基准跑分报告。